● HACKERNOON WEEKLY DIGEST · AI / AGENTS / LLM

AI-статьи недели с HackerNoon

Методы и эксперименты для тех, кто строит LLM-системы.

окно 2026-10-06 — 2026-10-12статей 10на радаре 3просмотрено 260
О чём эта неделя

В статьях недели повторяется один вопрос: как проверить, что агент сделал именно то, что разрешено и ожидалось. Авторы показывают проверки делегированных прав, границы Stop, сверку операции после одобрения и внешние hook для кодовых агентов. Для LLM-оценки и поиска по большим файлам есть отдельные воспроизводимые эксперименты с честно названными пределами.

01

Главные статьи недели

01

Пересчитайте LLM-бенчмарк по сохранённым ответам

✍ Kruthik JadhavHackerNoonllm-benchmarkingai-model-evaluation
О чём

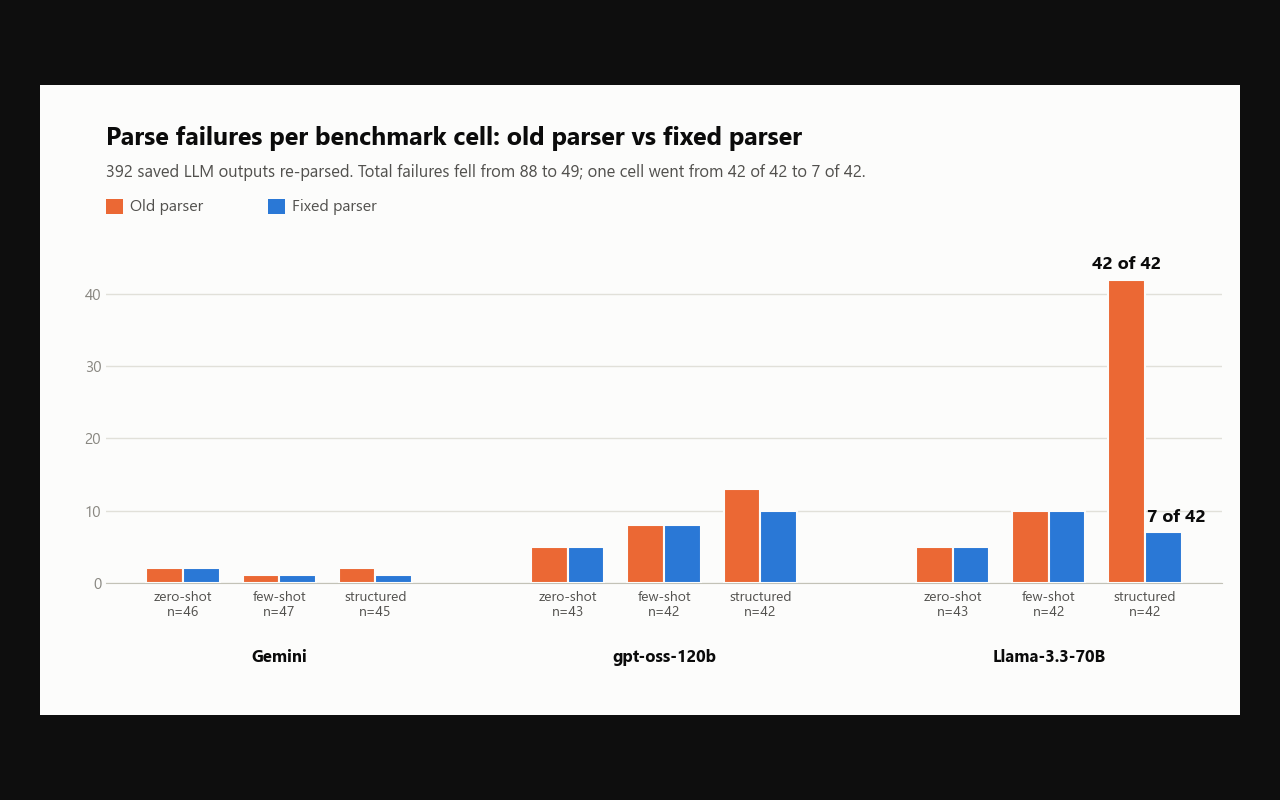
Команда нашла ошибку в разборе ответов модели. Она сохранила сырые ответы и пересчитала сетку после правки парсера, не меняя сами ответы.

Главное
  • Ошибки разбора формата снизились с 88 до 49. Содержательные ошибки остались в корпусе.
  • Открыты manifest, промпты, парсер, сырые ответы и регрессионные тесты.
  • Заметки о скрытом бюджете reasoning tokens не подтверждены логами основной сетки.
Попробовать за вечер
  • Сохраните raw output и finish_reason отдельно от результата парсера.
  • На одном фиксированном корпусе проверьте старый и исправленный парсер; не перезапускайте модель.
  • Сравните ошибки формата и содержательные ошибки по отдельности.
График из статьи показывает число ошибок разбора до и после исправления по ячейкам бенчмарка.из статьи
На картинке: График из статьи показывает число ошибок разбора до и после исправления по ячейкам бенчмарка.
02

Выдавайте дочернему агенту узкие права на каждый вызов

✍ Raju DandigamHackerNoonmulti-agent-systemsai-security
О чём

Автор предлагает описать полномочия дочернего агента отдельным grant и проверять их в шлюзе инструментов. Простого копирования всего набора инструментов родителя здесь слишком много.

Главное
  • В grant входят разрешённые инструменты и ресурсы, срок действия, audience и бюджет.
  • Шлюз проверяет grant при каждом вызове; запрещены расширение прав и повторная делегация.
  • Код схемный: policy.evaluate и resourceAllowed придётся реализовать в своём шлюзе.
Попробовать за вечер
  • Выберите одну делегированную задачу и запишите допустимые инструмент, ресурс и срок.
  • Проверьте вызов с чужим ресурсом, истёкшим grant и попыткой переделегации.
  • Считайте долю отклонённых запрещённых вызовов на тестовом наборе.
03

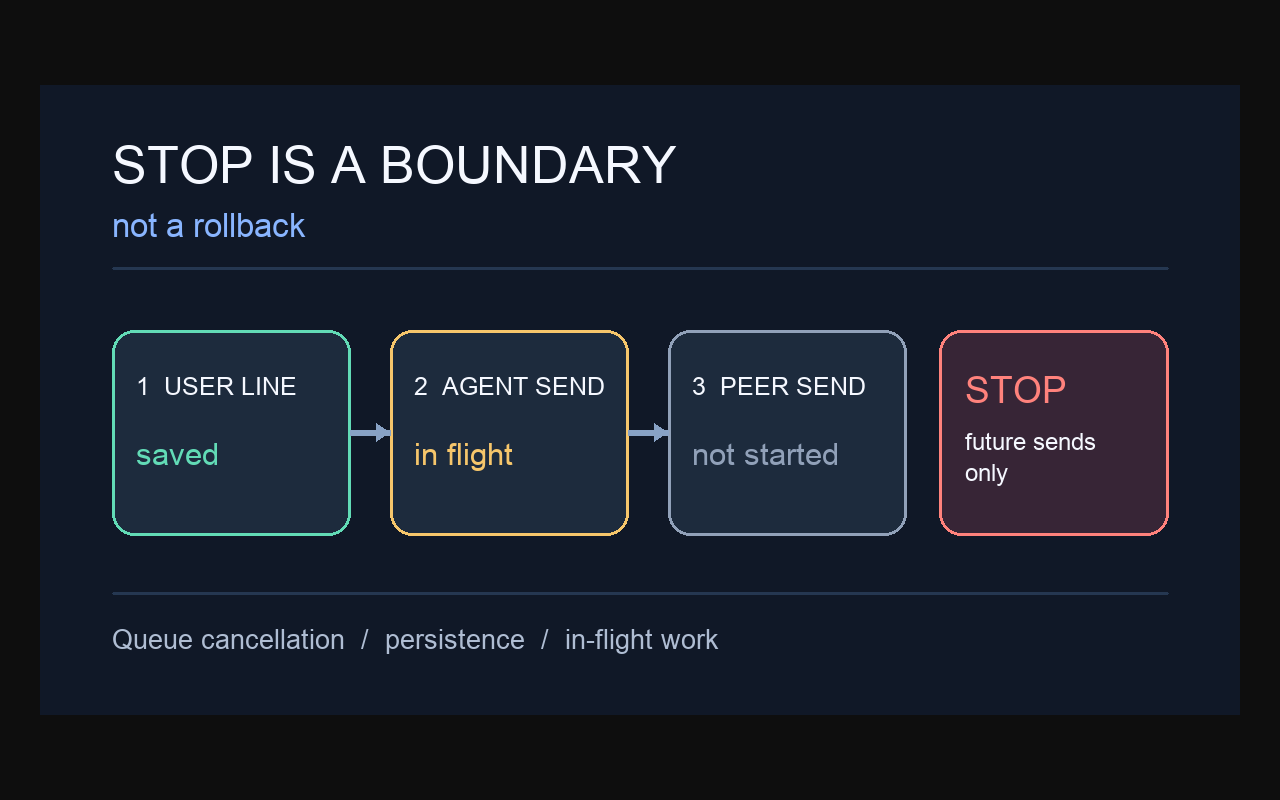
Проверяйте Stop на границе каждой отправки

✍ Zack ChewHackerNoonai-agent-orchestrationmulti-agent-systems
О чём

На примере queue runner статья разбирает момент, когда пользователь нажал Stop между сохранением сообщения и отправкой следующему агенту.

Главное
  • Stop запрещает новые отправки из очереди, но не отменяет уже начавшийся внешний вызов.
  • Автор предлагает тест с управляемым send: остановить сигнал в полёте и убедиться, что следующая отправка не началась.
  • Вывод относится к конкретному runner; у его send нет abort signal.
Попробовать за вечер
  • В тесте поставьте первый send на паузу и вызовите Stop.
  • Разрешите send и проверьте, что ответ сохранён, а следующий элемент очереди не отправлен.
  • Отдельно проверьте отмену HTTP-вызова и побочные эффекты внешнего сервиса.
Схема источника отделяет уже начатую отправку от будущих элементов очереди.из статьи
На картинке: Схема источника отделяет уже начатую отправку от будущих элементов очереди.
04

Разбирайте падение теста по уликам, а не по сообщению об ошибке

✍ Yevhen BozhenkoHackerNoonsoftware-developmentsoftware-testing
О чём

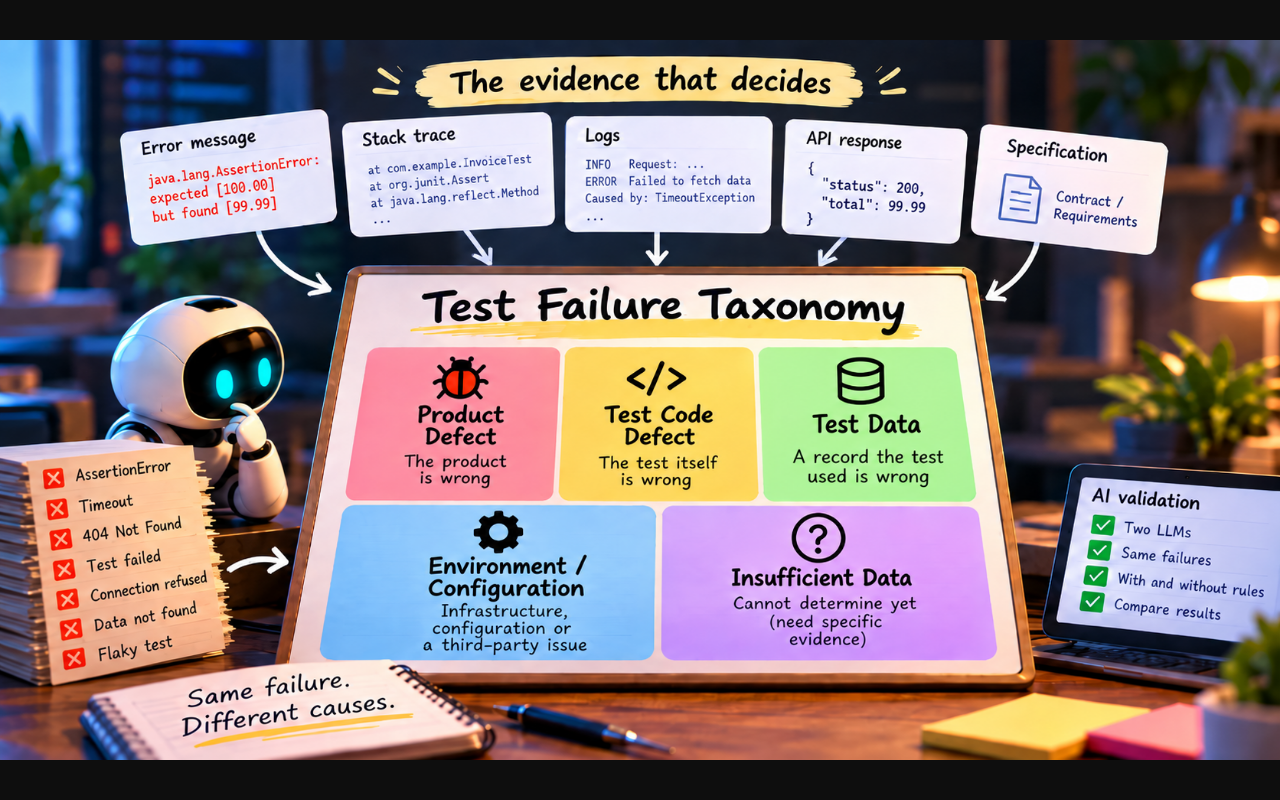
Автор составил правило triage для LLM: отличать дефект продукта, тестового кода, данных и окружения; при нехватке фактов запросить конкретный артефакт.

Главное
  • Открыты taxonomy, промпт, ответы двух моделей и оценка 21 сконструированного случая.
  • Ошибка продукта требует независимого контракта или спецификации, а не одного ожидания теста.
  • Один эталонный ярлык спорен; результаты на реальных CI-сбоях статья не измеряет.
Попробовать за вечер
  • Для одного упавшего теста соберите стек, логи, API-ответ и пункт спецификации.
  • Попросите классификатор назвать класс причины и недостающую улику; при недостатке данных оставьте неопределённость.
  • Сравните решение с человеком на своих реальных сбоях, отдельно считая неопределённые случаи.
Превью источника показывает классы причин падения теста и виды доказательств для triage.из статьи
На картинке: Превью источника показывает классы причин падения теста и виды доказательств для triage.
05

Соберите учебную трассу вызовов агента на Python

✍ Atul KumarHackerNoonai-agent-observabilitypython-ai-agent-tracing
О чём

Пошаговый код записывает события выполнения агента с task_id, именем инструмента, задержкой, ошибкой и числом повторов. Так видны дубли и место сбоя.

Главное
  • TraceEvent и AgentTracer дают простой формат события для одного запуска.
  • task_id связывает события одного выполнения, когда несколько агентов работают параллельно.
  • Пример хранит события в памяти и подменяет вызов модели заглушкой; для production нужны хранение и защита данных.
Попробовать за вечер
  • Оберните один вызов инструмента записью start, finish и error с единым task_id.
  • Добавьте retry_count и проверьте трассу при искусственной ошибке и повторе.
  • Проверьте, можно ли по записи отличить повторный вызов от нового действия.
06

Сверяйте одобренное действие прямо перед исполнением

✍ OffSecHackerNoonai-securityagentic-security
О чём

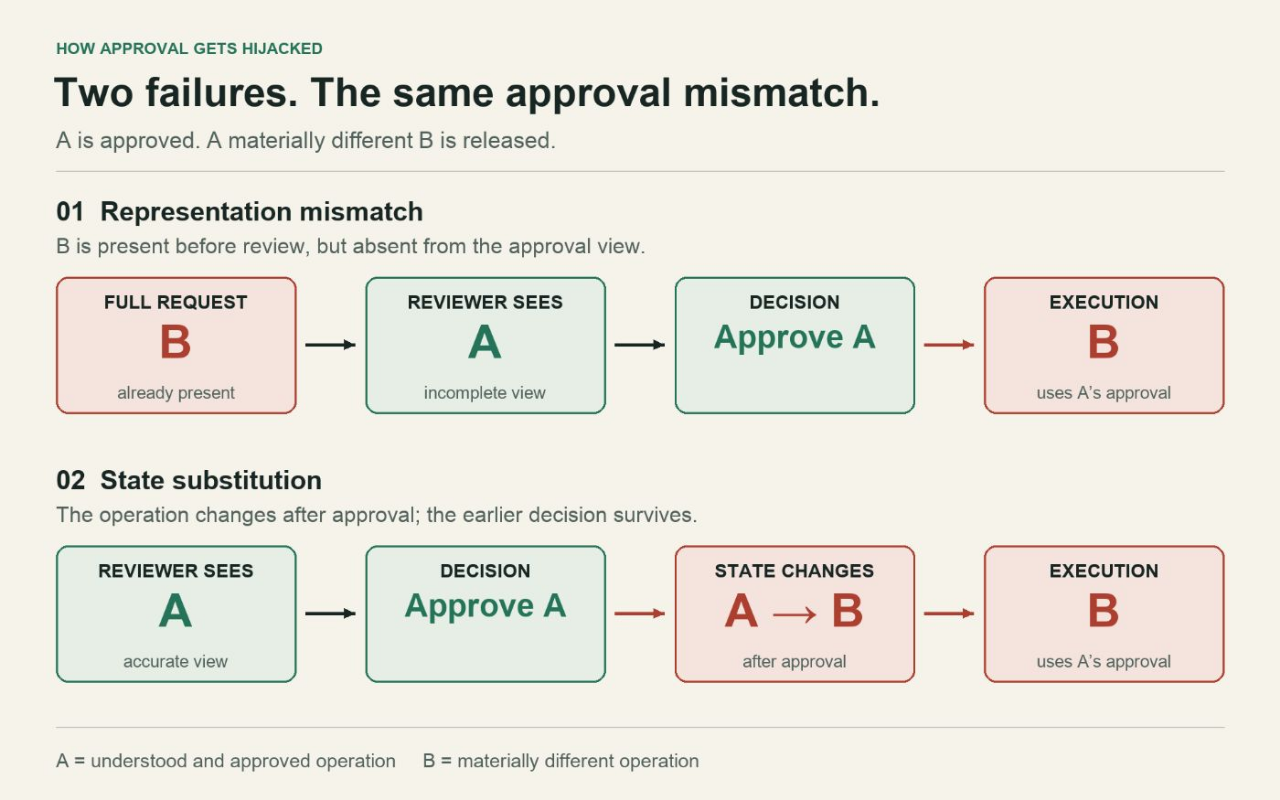
Loopjacking возникает, когда человек одобрил операцию A, а агент исполнил отличающуюся B. Статья показывает два пути: неполный экран согласования и подмену состояния после решения.

Главное
  • На исполнении нужно заново получить текущую операцию и сравнить её полные аргументы с одобренной записью.
  • Изменение суммы, адресата или запроса после согласования должно требовать нового решения.
  • Демонстрации касаются конкретных версий и конфигураций; распространённость проблемы не измерена.
Попробовать за вечер
  • Сохраните канонические аргументы операции вместе с решением человека.
  • В тесте измените один аргумент после approve и до dispatch.
  • Проверьте, что изменённый вызов блокируется и журнал показывает обе версии.
Авторская схема различает неполный экран согласования и изменение операции после одобрения.из статьи
На картинке: Авторская схема различает неполный экран согласования и изменение операции после одобрения.
07

Проверьте MCP-запросы к большому файлу вручную

✍ Ishank ChoudharyHackerNoonmcptypescript
О чём

Автор испытал Matryoshka/Lattice MCP на романе, логах и исходниках. Он сравнивал ответы запросов с grep и Python, чтобы отделить поведение движка от обещаний об агенте.

Главное
  • Показаны установка matryoshka-rlm@0.2.40, lattice_load, lattice_query и раскрытие handles.
  • Запросы составлял человек; работа LLM-агента и экономия токенов не проверены.
  • На сырых логах сумма дала ложное число, поиск зависел от диакритики, а граф вызовов не собрался на всех исходниках.
Попробовать за вечер
  • Подключите lattice-mcp к копии большого файла и задайте три проверяемых вопроса.
  • Сверьте найденные фрагменты и агрегаты с grep или коротким Python-скриптом.
  • Запишите случаи, где запрос вернул неверную агрегацию или неполный граф.
08

Проверьте память агента между двумя процессами

✍ Ishank ChoudharyHackerNoonai-agentstypescript
О чём

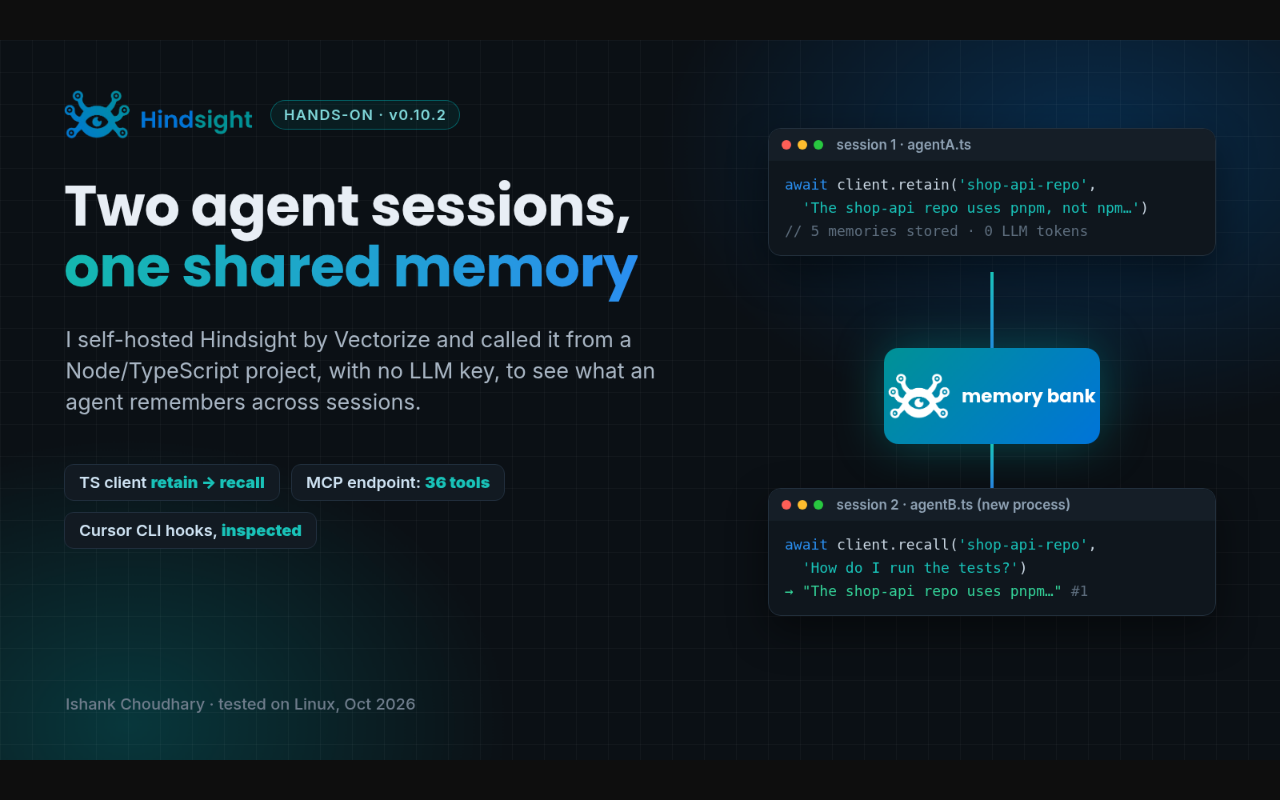
Автор установил Hindsight без LLM-провайдера, записал пять правил проекта и вызвал recall из нового процесса через тот же банк памяти.

Главное
  • В статье есть команды установки, отдельные скрипты записи и чтения, проверка после перезапуска и вызов MCP.
  • На пяти записях все результаты возвращались в каждом запросе: опыт проверяет ранжирование, а не фильтрацию.
  • Coding agent, извлечение фактов и работа с большим банком не испытаны.
Попробовать за вечер
  • Запустите Hindsight без LLM и запишите несколько проектных правил через retain.
  • В отдельном процессе вызовите recall по тому же bank name.
  • Проверьте порядок выдачи и повторите тест после перезапуска сервиса.
Схема источника показывает запись одной сессией и чтение из второго процесса через общий банк.из статьи
На картинке: Схема источника показывает запись одной сессией и чтение из второго процесса через общий банк.
09

Проверяйте защитные правила Go на сломанных вариантах

✍ Stanislav KorolevHackerNoongolangai-agents
О чём

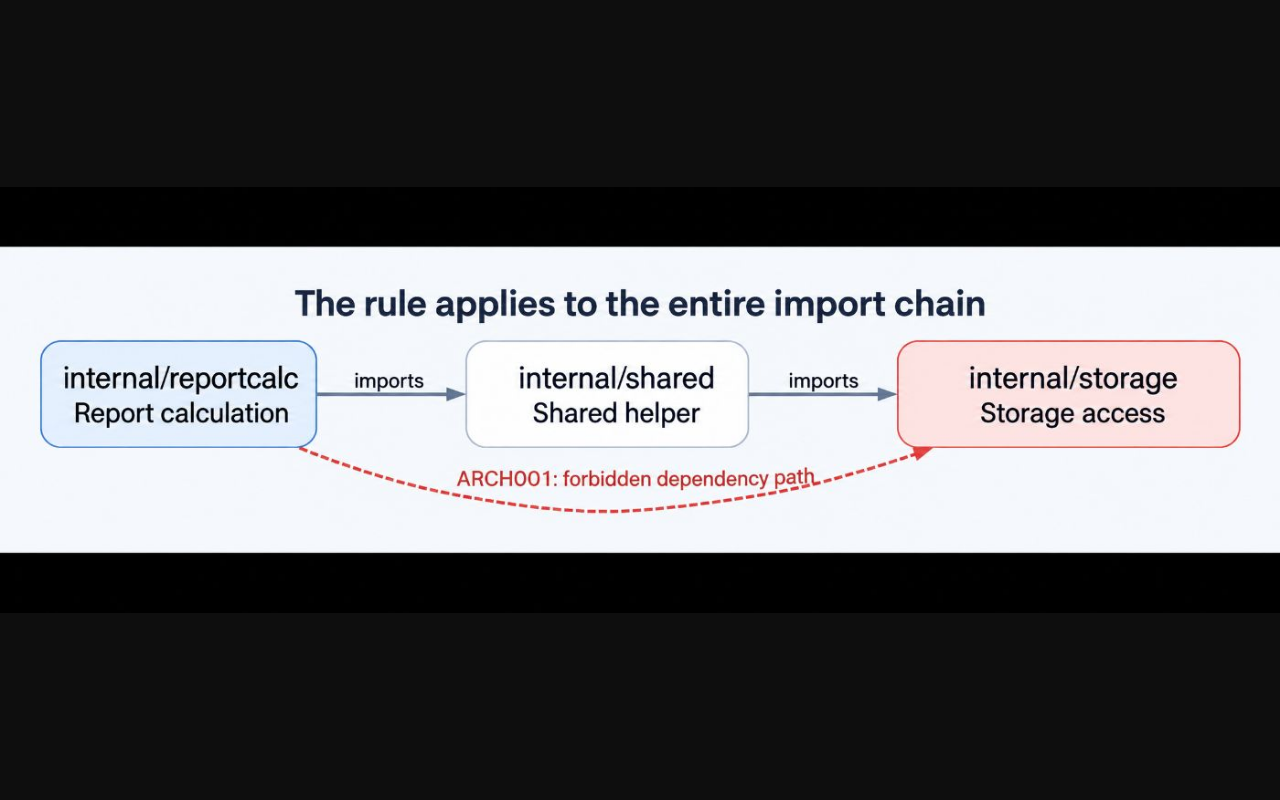
Автор показывает, как превращать повторяющиеся ошибки кодового агента в lint, тесты и проверку графа импортов. Репозиторий создаёт неисправные версии кода и проверяет диагностику.

Главное
  • Проверки покрывают race, cancellation, обработку ошибок и транзитивные импорты.
  • Отдельный сценарий отличает найденное нарушение от падения сборки или таймаута проверки.
  • Зелёные тесты доказывают только выбранные классы дефектов; build tags требуют внимания.
Попробовать за вечер
  • Возьмите один повторяемый дефект Go и создайте сломанную фикстуру.
  • Запустите соответствующую проверку на сломанной и исправленной версиях.
  • Убедитесь, что timeout или build error не считаются обнаружением нарушения.
Схема источника показывает запрещённый путь зависимости через промежуточный пакет.из статьи
На картинке: Схема источника показывает запрещённый путь зависимости через промежуточный пакет.
10

Закрепите повторяемую ошибку агента внешним hook

✍ Victor Del PuertoHackerNoonai-agentsclaude-code
О чём

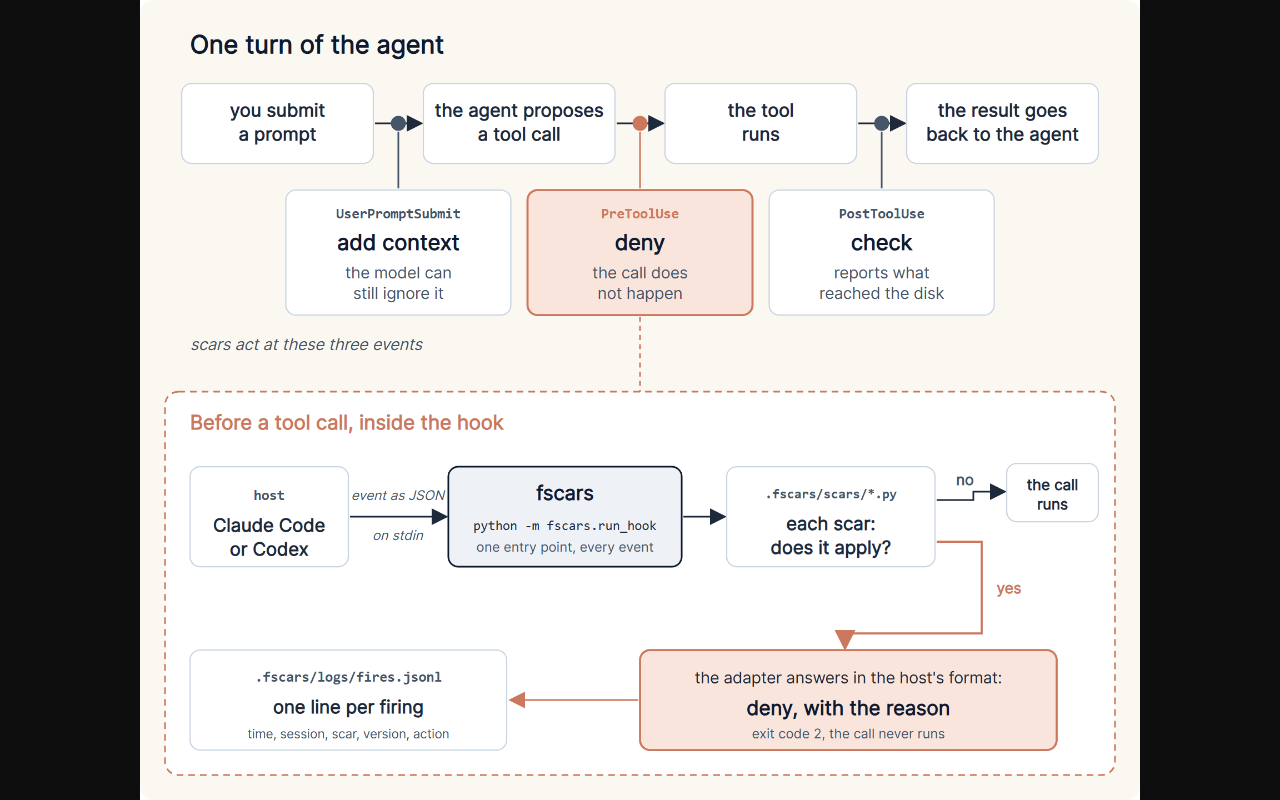
Автор превратил ошибку с backticks внутри двойных кавычек Bash в проверку перед вызовом инструмента. fscars запускает такую проверку вне модели.

Главное
  • Есть пакет, команды установки и пример scar с событием PreToolUse.
  • В одном workspace число связанных heredoc-ошибок упало с 47 до 0; сравнение наблюдательное.
  • Широкая блокировка backticks дала 92% безвредных срабатываний, поэтому нужно мерить ложные запреты.
Попробовать за вечер
  • Выберите повторяемую ошибку с точной сигнатурой и добавьте pre-tool hook.
  • Запустите негативный и допустимый пример через реальный adapter.
  • Считайте заблокированные опасные действия и ложные запреты, затем сузьте правило.
Схема из статьи показывает, как pre-tool hook останавливает вызов и записывает причину.из статьи
На картинке: Схема из статьи показывает, как pre-tool hook останавливает вызов и записывает причину.
02

На что обратить внимание

Полезные схемы, для которых пока не показана работающая проверка.

Eval агента должен проверять состояние после действия

Хорошая схема: reset состояния, инъекция сбоя, проверка ledger и release gate. YAML иллюстративен; harness и результаты испытаний в статье отсутствуют.

Читать ↗

Stop требует учёта уже допущенной работы

Статья предлагает хранить решения о допуске, закрывать новые dispatch и разбирать операции в очередях. Сценарий гипотетический, работающий kill switch не показан.
Читать ↗

Памяти агента нужна история происхождения

Схема MemoryClaim и DerivedArtifact предлагает хранить scope, validity и независимые корни доказательств. Полной реализации и проверки на корпусе нет.

Читать ↗
03

Мой план на неделю

Сделать: Пересчитать один eval на сохранённых raw outputs и отделить ошибки формата от содержания.
до среды
Сделать: Проверить изменение аргумента между approve и dispatch в тестовом инструменте.
до пятницы
Сделать: Добавить один pre-tool hook для повторяемой ошибки и измерить ложные блокировки.
до воскресенья
#

Метаданные

сгенерировано 2026-10-12T06:10:12.694432Z
окно 2026-10-06 — 2026-10-12 (7 дней)
отсканировано / в дайджест 260 / 13
источник поисковый индекс HackerNoon и полные тексты статей через Firecrawl
покрытие полное; отказов: 0
счётчик прочтений 164/260
×
Открыть статью